模型、订阅与工具选择
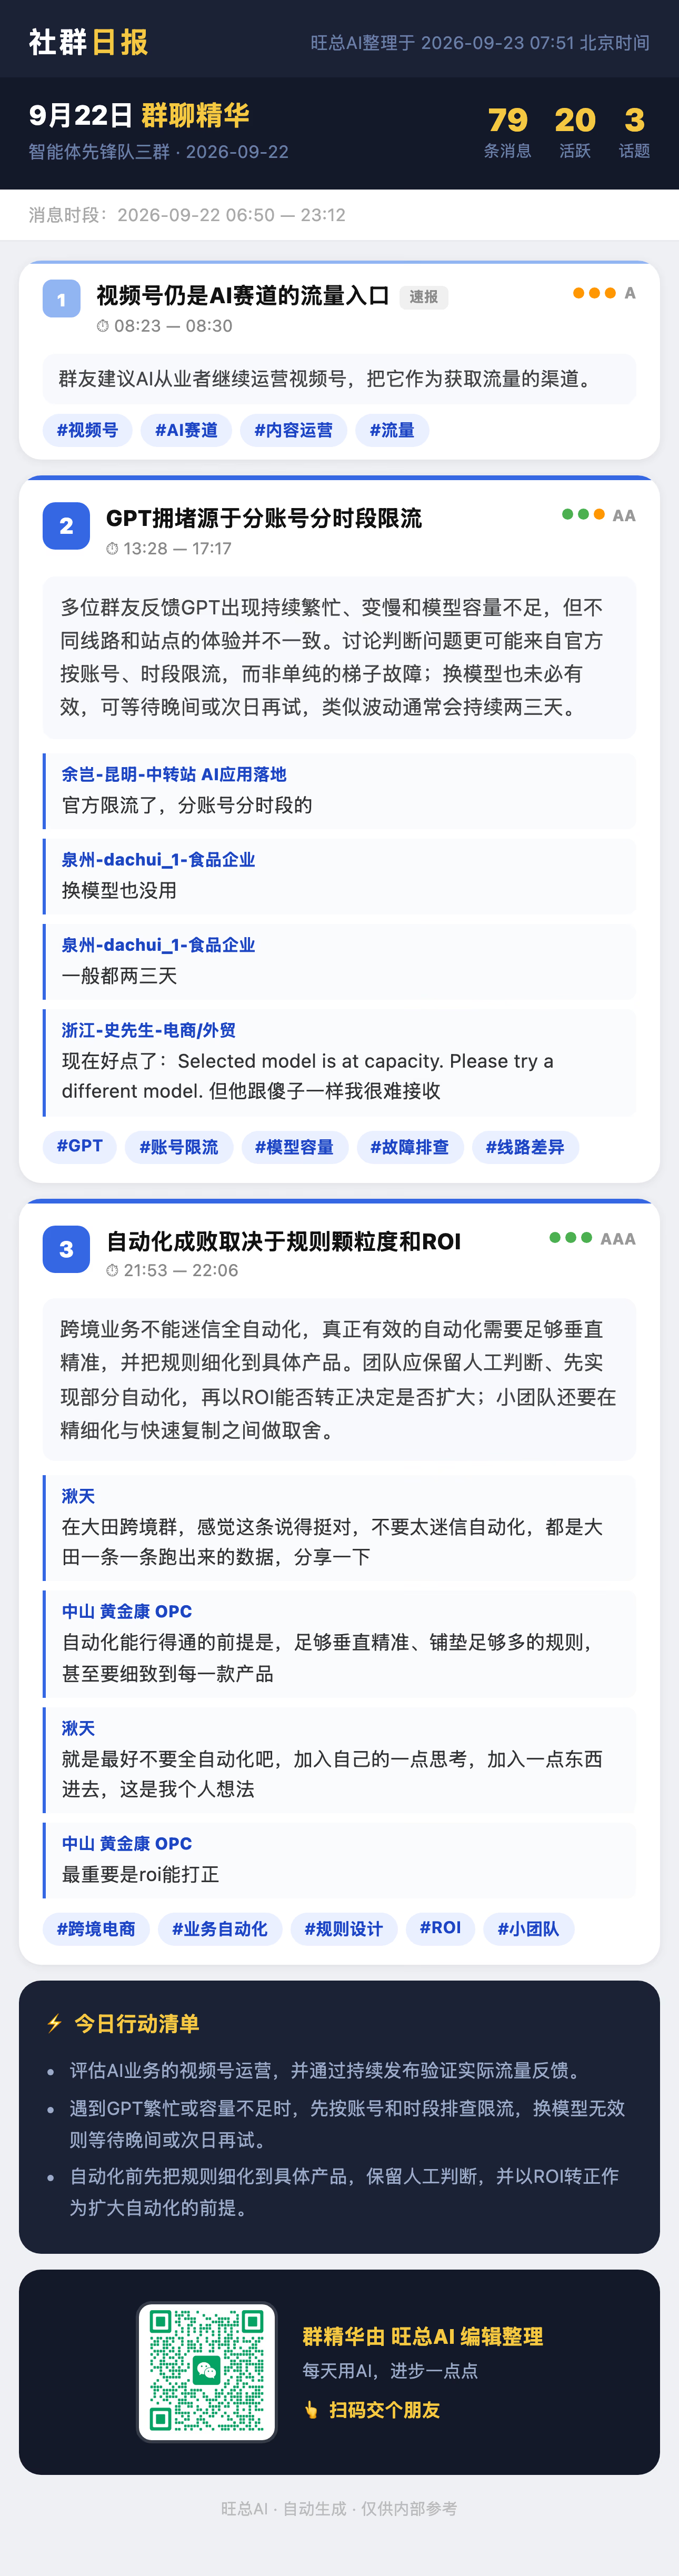
模型/订阅/工具选择DeepSeekGPT故障排查
核心观点
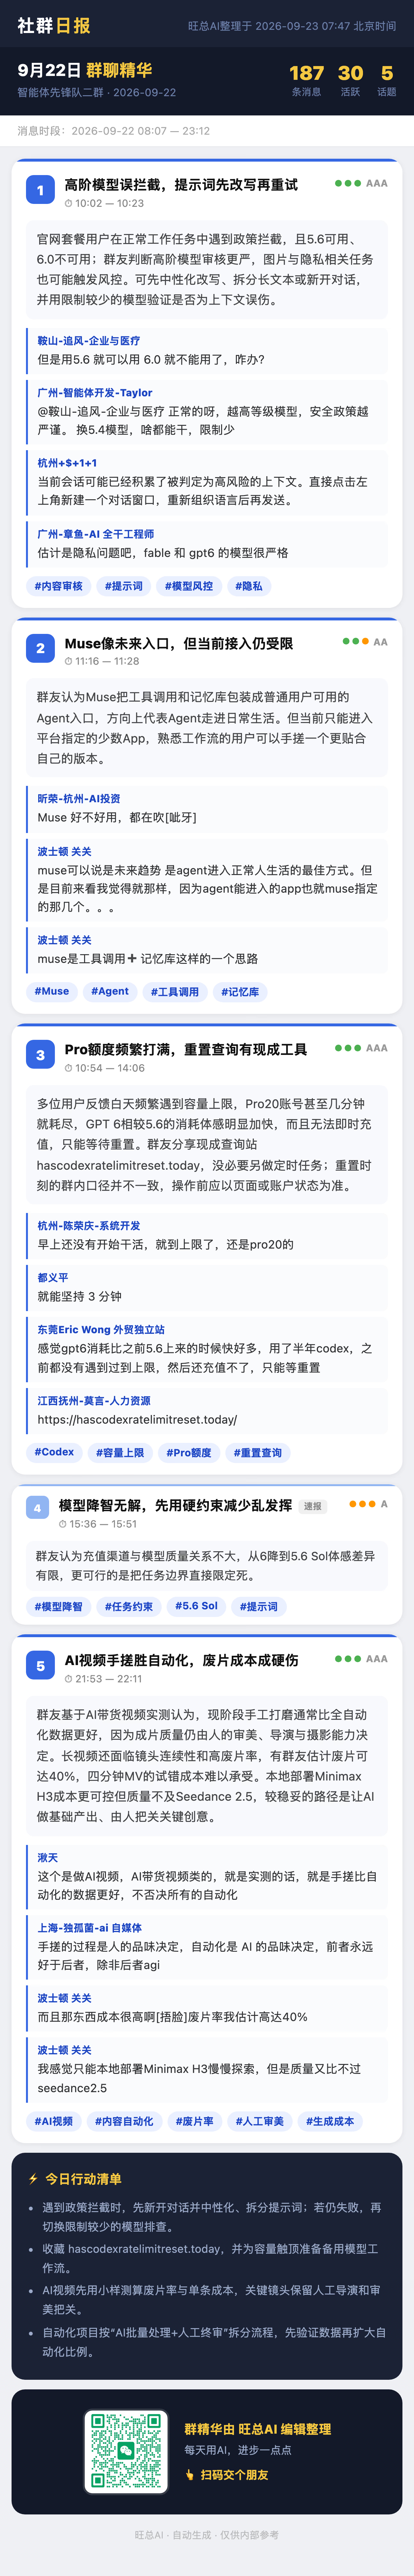
多位用户反馈白天频繁遇到容量上限,Pro20账号甚至几分钟就耗尽,GPT 6相较5.6的消耗体感明显加快,而且无法即时充值,只能等待重置。
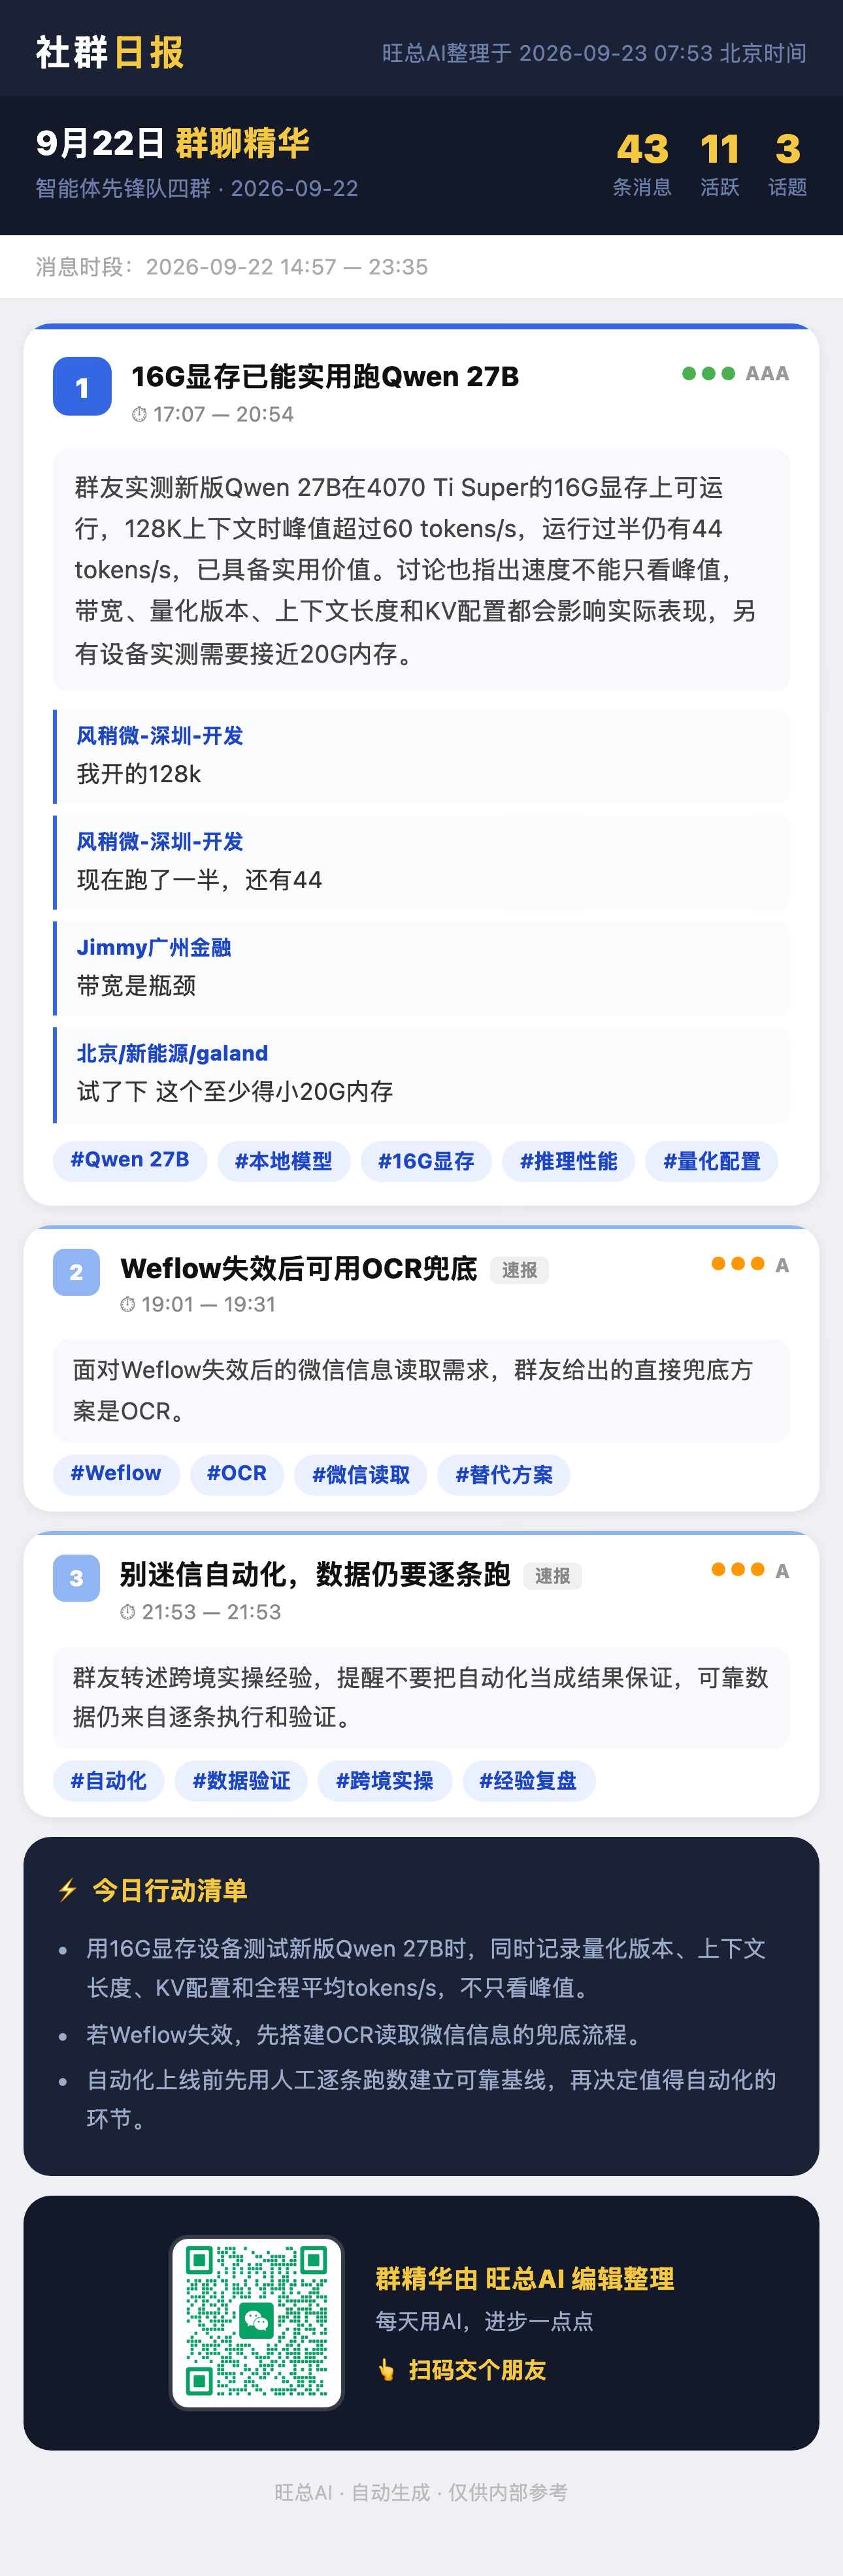
群友实测新版Qwen 27B在4070 Ti Super的16G显存上可运行,128K上下文时峰值超过60 tokens/s,运行过半仍有44 tokens/s,已具备实用价值。
群友分享称,DeepSeek V4-Pro 的前缀缓存命中与未命中价格相差 50 倍,中途改项目文档、切模型、增减 skill 或跨边界压缩都可能让缓存碎裂。
可执行建议
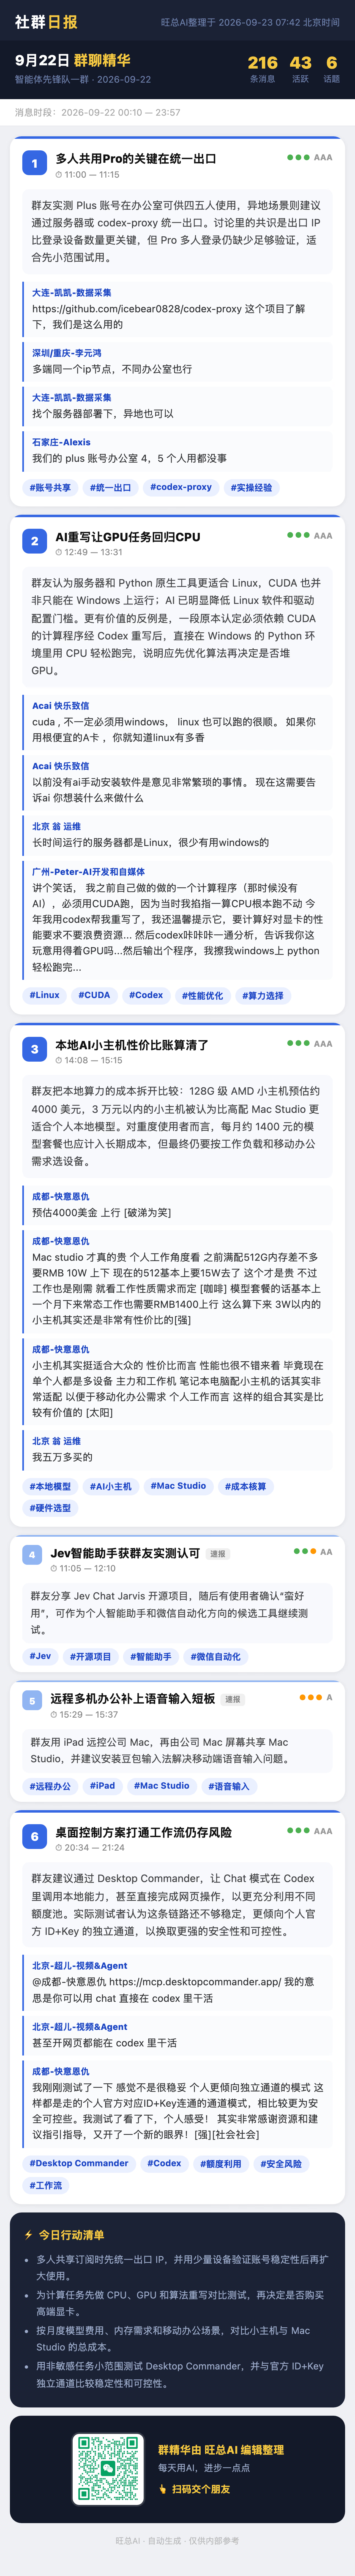
多人共享订阅时先统一出口 IP,并用少量设备验证账号稳定性后再扩大使用。
为计算任务先做 CPU、GPU 和算法重写对比测试,再决定是否购买高端显卡。
按月度模型费用、内存需求和移动办公场景,对比小主机与 Mac Studio 的总成本。
展开知识正文
围绕模型能力、额度、订阅稳定性和工具组合,提炼更稳的选型判断。